뉴스에서 소버린 AI, 국가대표 AI라는 말 자주 보이죠? 미국 빅테크의 AI만 쓰는 게 아니라 우리 손으로 만든 AI를 갖자는 흐름인데요. 오늘은 소버린 AI가 정확히 무슨 뜻인지, 왜 필요한지, 그리고 한국의 독자 AI 파운데이션 모델 프로젝트가 지금 어디까지 왔는지 쉽게 정리해볼게요.
소버린 AI란? 한 줄 정의
소버린(Sovereign)은 “주권을 가진”이라는 뜻이에요. 그래서 소버린 AI는 한 나라가 자기 데이터, 컴퓨팅 인프라, AI 모델을 스스로 갖추고 통제하는 것을 말해요.
- 데이터: 우리 언어와 사회를 담은 학습 데이터
- 인프라: AI를 학습·운영할 GPU와 데이터센터
- 모델: 해외 모델에 기대지 않는 자체 기반(파운데이션) 모델
쉽게 말해 전기를 수입만 하지 않고 우리 발전소를 갖는 것과 비슷한 개념이에요.
소버린 AI가 왜 필요할까?
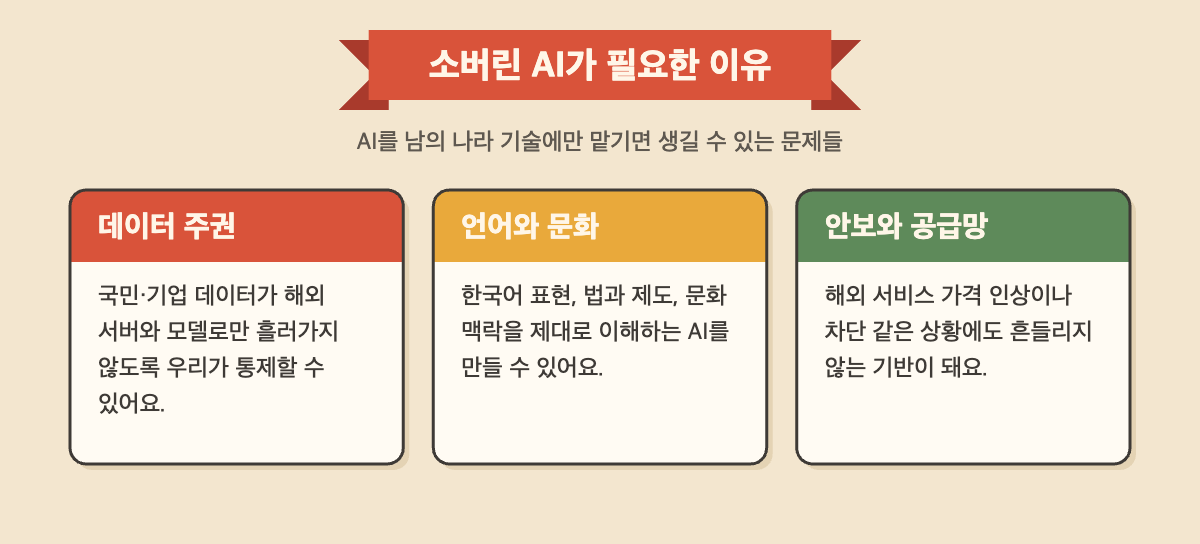
AI가 검색, 업무, 교육, 행정까지 들어오면서 어떤 AI를 쓰느냐가 곧 국가 경쟁력이 됐어요. 해외 모델에만 의존하면 서비스 정책이나 가격이 바뀔 때 대응하기 어렵고, 민감한 데이터를 다루는 공공 분야에서는 더더욱 자체 모델이 필요해요.
한국의 국가대표 AI, 독자 AI 파운데이션 모델 프로젝트
과학기술정보통신부는 독자 AI 파운데이션 모델(독파모) 프로젝트로 한국형 초거대 AI를 키우고 있어요. 여러 팀이 경쟁하면서 단계별 평가를 거쳐 점점 압축되는 방식이에요.
| 구분 | 내용 |
|---|---|
| 목표 | 글로벌 최고 수준 모델 대비 약 95% 성능의 국산 모델 |
| 지원 | 주로 GPU(AI 연산 자원)를 참여 팀에 배분 |
| 2차 평가 결과 (2026.8) | 업스테이지, SK텔레콤, LG AI연구원 통과 / 모티프테크놀로지스 탈락 |
| 평가 방식 | 벤치마크 40점 + 전문가 평가 35점 + 사용자 평가 25점 |
| 다음 단계 | 3차 평가에서 3팀 → 2팀으로 압축 예정 |
2차 평가에서는 사용자 평가가 순위에 가장 큰 영향을 줬다고 해요. 성능 점수뿐 아니라 실제로 써봤을 때 얼마나 쓸모 있는지가 중요하다는 뜻이죠. 탈락한 모티프는 독립 지표(AAII)에서 가장 높은 점수를 받고 핵심 기술을 직접 만들었지만, 사용성 점수가 상대적으로 낮았어요.
앞으로의 과제: 글로벌 모델과의 격차
- 독립 지표 기준으로 국내 최고 점수는 47점, 글로벌 선두 모델은 61~63점 수준이라 아직 격차가 있어요
- 목표(95%)를 이루려면 최소 57점 정도가 필요하다는 분석이에요
- 예산이 한정돼 있어 정부는 한 팀에 자원을 몰아주는 방안도 검토하고 있어요
결국 소버린 AI는 “한 번 만들고 끝”이 아니라, 계속 투자하고 실제 서비스로 쓰이면서 키워가야 하는 장기전이에요.
한눈에 정리
- 소버린 AI = 데이터·인프라·모델을 스스로 갖춘 AI 주권
- 필요한 이유: 데이터 주권, 한국어·문화 이해, 안보와 공급망 안정
- 국가대표 AI 2차 평가 통과: 업스테이지·SKT·LG AI연구원
- 과제: 글로벌 모델과의 성능 격차, 한정된 예산
소버린 AI 자주 묻는 질문
소버린 AI는 해외 AI를 쓰지 말자는 건가요?
아니에요. 해외 AI도 함께 쓰되, 꼭 필요한 영역에서는 자체 기술로 대체할 수 있는 선택지를 확보하자는 의미에 가까워요.
파운데이션 모델은 뭔가요?
방대한 데이터로 미리 학습해 번역, 요약, 대화 등 여러 일에 두루 쓸 수 있는 기반 AI 모델이에요. ChatGPT 같은 서비스의 뼈대에 해당해요.
국가대표 AI는 일반인도 쓸 수 있나요?
참여 기업들이 자체 서비스나 공개 모델 형태로 선보이고 있어요. 서비스 형태는 기업마다 달라서 각 회사 발표를 확인하는 게 좋아요.
참고 자료
- 머니투데이 – 국가대표 AI 2차 선발전 결과 (2026.8)
- 머니투데이 – 연장전 된 2차전, 독파모 재편 논의 (2026.8)
- 바이라인네트워크 – 2차 단계평가 브리핑 (2026.8)
여러분은 국산 AI와 해외 AI 중 어떤 걸 더 자주 쓰시나요? 언젠가 “한국 AI가 제일 편하다”는 말이 자연스러워지는 날이 오길 응원하게 되네요.